五週前,Meta年度股東大會上,扎克伯格被問到是否會與Amazon和Microsoft在雲端領域競爭。他給出了明確的回應:
「It's definitely on the table.」
從「考慮中」到「在建工程」,只用了五週。
7月1日,彭博社爆出消息:Meta內部正在推進一個代號為 「Meta Compute」 的項目,計劃向外部客戶出售富餘的AI算力。
兩條路徑同時推進:一是託管模型訪問——把Llama和Muse Spark等模型開放給企業客戶,按Token用量收費,對標AWS Bedrock;二是裸算力直接銷售——把GPU集群按小時租出去,對標CoreWeave。
消息一出,市場用腳投票。
數字會說話:漲的漲死,跌的跌死
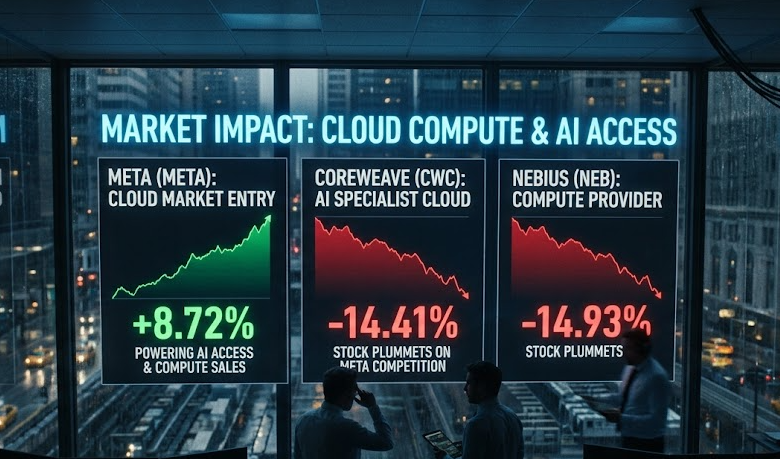
Meta當日收盤漲8.81% ,盤中一度漲超10%,總市值達1.57兆美元。
投資人將其解讀為扎克伯格對「千億AI投入能否收回」質疑的正面回應。
但另一頭,是一場屠殺。
費城半導體指數暴跌超6%。
AI算力租賃商集體崩盤:
- Nebius(NBIS)暴跌16.96%
- CoreWeave(CRWV)暴跌13.92% ,收85.69美元
- Hut 8跌8.98%,WhiteFiber跌8.62%,Bitdeer Technologies跌7.49%,IREN Ltd跌6.52%
半導體股同步遭殃:美光科技跌8.37%,閃迪跌超11%,英特爾跌超7%。
Meta一句話,市值漲了,別人的市值沒了。
1450億美元的賭注,到底建了多少?
要理解Meta為什麼要賣算力,先得知道它建了多少。
2026年4月,Meta將全年資本支出指引上調至1250億至1450億美元,較2025年的722億美元幾乎翻倍。
這不是Meta一家的問題。微軟、Google、Amazon也在同步瘋狂砸錢。
2026年,四大科技巨頭合計資本支出逼近7000億美元,較2025年的約4100億美元增長77%。
但Meta的處境與其他三家有一個根本性區別:
微軟有Azure、Google有GCP、Amazon有AWS。它們的鉅額資本支出有雲端服務收入來直接對沖。Meta沒有。 它之前的每一分錢基礎設施投入都是純粹的成本項。
市場的核心質疑是:一年花1350億美元建數據中心,回報到底在哪裡?
為什麼會有「富餘」算力?
算力這個東西,有個物理學問題:它不是均勻消耗的。
一個大語言模型的訓練任務,可能在幾個月內100%吃滿幾萬張GPU。但訓練完成之後,這批集群的利用率會驟降到30%到50%——只剩下推理請求在跑,而推理的算力需求遠低於訓練。
Meta的訓練節奏是公開已知的:Llama 4訓練完了,Llama 5還在路上。中間的空窗期,集群就在那裡,耗著電費,不產生回報。
扎克伯格的策略叫「先囤積,後決策」。
但如果囤太多了呢?
真正的問題:當最大的買家開始做賣家
CoreWeave和Nebius的跌幅如此劇烈,原因很直接:
第一,直接競爭威脅。 CoreWeave和Nebius的生意模式本質上就是「批量採購GPU→搭建集群→加價賣給AI公司」。毛利率高的前提是市場上GPU算力供給緊張、客戶沒有太多替代選擇。
Meta一旦下場,就多了一個算力供給量級巨大的玩家。而且Meta的GPU採購成本比neocloud公司更低——它直接跟Nvidia和AMD簽數百億美元的戰略大單,拿到的是最優價格。
第二,身份衝突。 CoreWeave目前最大的客戶之一就是Meta。2026年4月,CoreWeave宣布與Meta擴大AI基礎設施協議,總規模達210億美元,服務期至2032年。
現在Meta要自己做同樣的事——等於你的甲方宣布要變成你的競爭對手。
市場自然的反應就是質疑:這210億合同到期後還會續嗎?Meta是不是在花錢買時間,等自己的雲業務建成後就不再需要CoreWeave了?
第三,估值敘事的崩塌。 CoreWeave在2025年3月IPO時講的故事是「AI算力需求爆炸式增長、供給極度稀缺、我們是稀缺供給方」。這個敘事支撐了它從零到市值數百億美元的火箭式增長。
但Meta入場賣算力,直接動搖了 「供給稀缺」 這個核心前提。
說句實在話
真正值得關注的,其實不是Meta要賣算力。
而是:AI軍備競賽可能正在進入下半場。
過去兩年,所有人都在比誰敢花錢、誰能搶到GPU、誰的數據中心規模更大。四巨頭2026年合計CapEx約7000億美元,但AI直接帶來的增量收入可能只有幾百億美元量級。
投入產出比嚴重不匹配。
瑞銀的判斷很直接:「出售雲算力或模型訪問權,理論上會帶來比等待Meta Business Agents和Meta AI聊天機器人規模化更快的近期收入,並緩解2027年EPS持平或收縮的擔憂。」
翻譯成白話:Meta需要錢,需要快點看到回報。
扎克伯格在股東會上的原話是:「如果有一天我們覺得建設過度了,那麼這也是一個可選方案。這也在一定程度上增強了我們繼續投資建設的信心。」
「如果建多了」——他自己都在為建多了的可能性留退路。
做雲這個選項的存在本身,就是他敢繼續花錢的底氣。
但反過來讀同一句話,也能讀出焦慮。有評論很犀利:「如果自己用不完,就把成本轉嫁給別人。這不是一個對AI未來充滿信心的人會說的話。如果Zuckerberg真的確信內部需求能吃完所有算力,他沒有任何理由把寶貴的GPU資源分給外部競爭者使用。」
Meta做雲,究竟是AI算力業務的華麗變現,還是AI泡沫的第一聲警鐘?
答案可能取決於一件事:Llama 5什麼時候來,以及它需要多少算力。
如果下一個大模型很快就需要餵滿所有集群,那今天的「富餘」只是短暫的技術性空窗。但如果下一個大模型的訓練間隔越來越長——那今天建好的數據中心,可能真的太多了。
未來幾個月,市場將持續觀察:Meta的雲業務具體什麼時候上線?CoreWeave和Nebius的合約會不會被提前調整?其他巨頭會不會跟進?
當花錢最大膽的人,開始準備做賣家的那一天——至少應該停下來看一眼,他到底在怕什麼。
FAQ
Q1:Meta為什麼要對外出售AI算力?
Meta2026年資本支出高達1250億至1450億美元,幾乎是2025年的兩倍。但Meta不像微軟、Google、Amazon那樣有雲端業務收入來對沖巨額投入。出售富餘算力是為了增加變現渠道,緩解市場對「錢花到哪去了」的質疑。
Q2:CoreWeave和Nebius為什麼暴跌?
這兩家公司的商業模式是「批量買GPU→搭集群→加價賣算力」。Meta本身是它們的最大客戶之一(CoreWeave剛簽了210億美元合約),現在Meta要自己賣算力,等於客戶變成了競爭對手。市場認為這個商業模式的護城河被動搖了。
Q3:Meta做雲端會成功嗎?
Meta有GPU、有數據中心、有錢——但它缺企業級雲端服務的關鍵能力:多租戶隔離架構、安全合規認證、細粒度計費系統、全球網絡接入節點,以及最重要的——to B銷售團隊。短期內更可能走「批髮型」算力出售路線,面向少數大客戶簽長期合同,而不是像AWS那樣提供幾百種服務的完整雲平台。